前言
你有没有过这样的经历——
在拥挤的地铁里,对着手机喊了三遍“喂,听得到吗”,对方还是说“你那边太吵。”
居家开会时,键盘声、空调声、宠物叫声交织,同事说“你那边信号不好吗?”
骑行录制Vlog时,呼呼的风声淹没了周边其他的环境声,让原本的骑行回忆失去了声音的润色。
在移动互联网和AIoT时代,“听得清” 已经成为语音交互的底线要求。然而真实世界的声学环境远比实验室复杂——地铁的轰鸣、办公室的键盘声、车内的路噪、户外的风声,时刻威胁着语音通信的质量。
今天我们就从用户场景、核心需求、行业痛点与解决方案四个维度,拆解音频降噪技术的演进逻辑与破局之道。
1
噪声无处不在:四个场景,四种“听不清”
音频降噪的应用场景已渗透到生活的每个角落,大致可分为四大类:
移动通信场景是最基础的需求阵地:
用户在地铁、街道、商场等环境中进行手机通话或视频聊天,背景噪声往往高达70-85dB,直接掩盖语音信号,导致对方频繁“喂,听得到吗?”
远程办公场景在近几年爆发式增长:
居家环境的噪声以非稳态成分为主——键盘敲击(瞬态,2-5ms持续时间)、空调低频轰鸣(稳态,<500Hz)、家人交谈(方向性干扰)。这些噪声在时频域上与语音高度重叠,单一算法难以兼顾。此外,多参会者场景要求降噪算法支持全双工通信,即在近端说话的同时,必须实时抑制从扬声器泄漏的回声与环境噪声,这对算法的因果性(causality)提出了严苛要求。
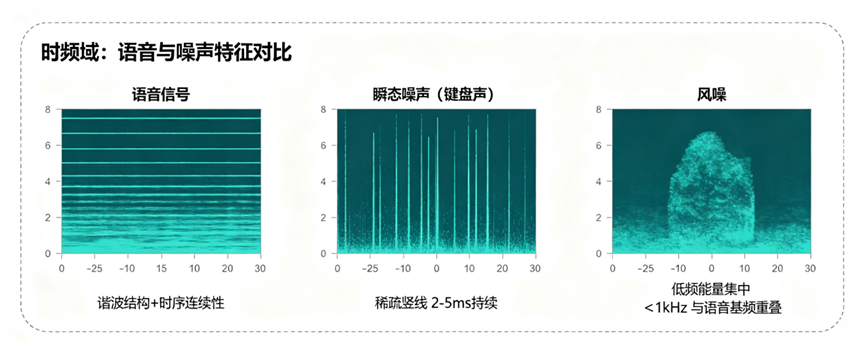
图1 时频域:语音与噪声特征对比
车载场景是典型的高噪声战场:
车速80km/h时,车内噪声可达75dB以上,发动机、轮胎与风噪叠加,再加上车内多人的语音干扰,对车载通话和语音助手构成极大挑战。
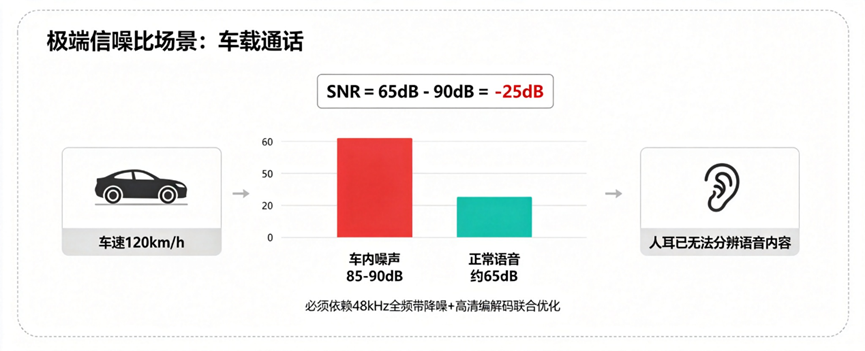
图2 极端信噪比场景:车载通话
智能穿戴与家居场景则对降噪提出了更高要求:
TWS耳机需要在降噪与通透模式间无缝切换;智能音箱需要在3-5米的远场距离下,从电视声、交谈声中提取唤醒词;户外录音录像设备需要对风噪进行抑制,提升目标音频信号的清晰度。
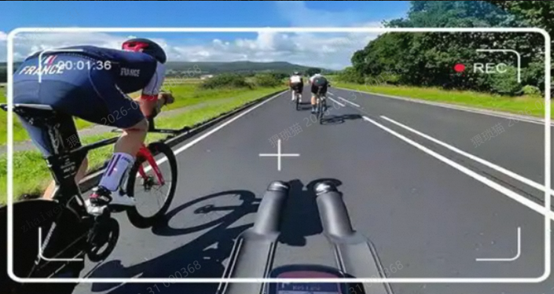
图3 骑行场景:风速噪声干扰
这些场景的共同点在于:用户不再满足于“能听见”,而是要求“听得清、听得自然、听得舒适”。
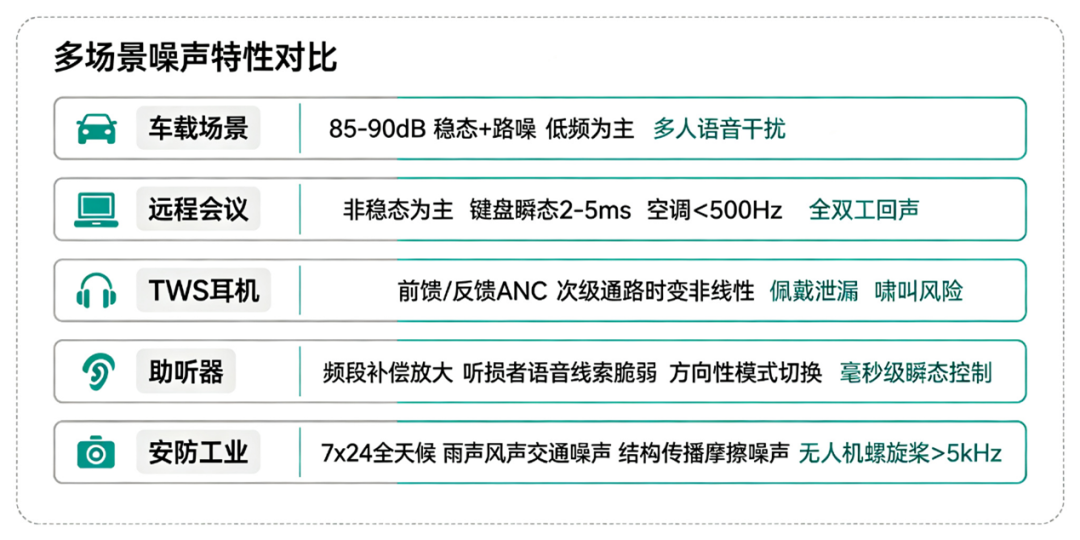
图4 应用场景噪声类型
2
好的降噪,不只是“把声音变小”
围绕上述场景,音频降噪的核心需求可以归纳为四个层面:
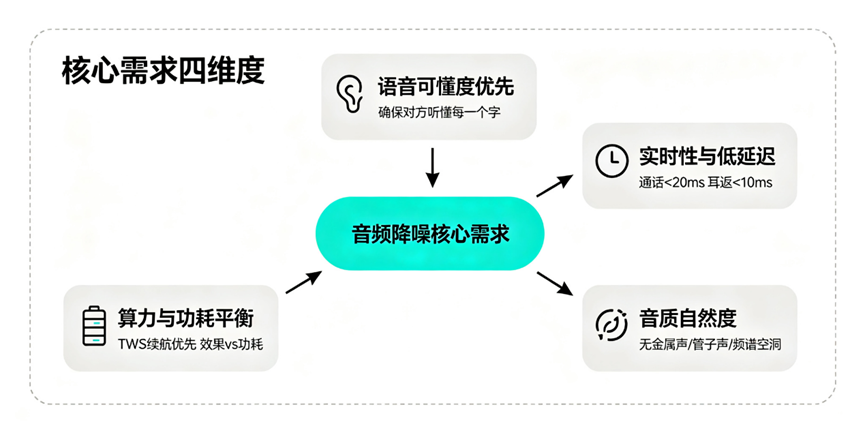
图5 核心需求四维度
第一,语音可懂度优先。
通话和语音交互场景的首要目标是确保对方能听懂每一个字,而非单纯追求噪声压得多低。过度降噪导致语音发闷、缺字,反而降低沟通效率。
客观评价上,STOI(Short-Time Objective Intelligibility)预测可懂度,PESQ/PLCMOS评估音质自然度;主观评价则遵循ITU-T P.835标准,分别对SIG(信号失真)、BAK(背景噪声干扰)、OVRL(整体质量)进行5分制评分。高端会议系统要求OVRL≥3.5,而助听器场景对SIG的容忍度更低,要求≥4.0。
第二,实时性与低延迟。
实时通话通常要求算法延迟低于20ms,直播耳返甚至要求低于10ms。这意味着算法必须在极短的音频帧内完成分析和处理,无法使用高复杂度的离线模型。帧长与帧移直接决定算法延迟:20ms帧长+10ms帧移是语音处理的常见配置,但引入至少20ms的算法延迟。若叠加AEC的20-40ms和编解码的20ms,总延迟轻易突破ITU-T G.114建议的150ms上限。
因此,低延迟降噪常采用10ms帧长、50%重叠的激进配置,代价是频谱分辨率下降(仅400个频点@48kHz),增加了谐波恢复的难度。
第三,音质自然度。
视频会议和直播场景对语音自然度要求极高。降噪后的语音不能出现"金属声"、"管子声"或明显的频谱空洞,需要保留原始语音的音色和情感。
第四,算力与功耗平衡。
TWS耳机、智能手表等设备的电池容量有限,降噪算法必须在效果与功耗之间找到最佳平衡点,不能为了降噪而牺牲续航。100ms延迟@48kHz/16bit单声道需要4800个采样点,循环缓冲区占用约9.6KB;若采用32bit浮点深度学习模型,参数量需压缩至数百KB级别,必须依赖INT8量化、权值共享或知识蒸馏。
以艾为帝江®音频方案为例,语音助手前端降噪的算力仅需60MCPS,通话场景约200MCPS,ROM+RAM合计不到1MB,才能在TWS等小体积设备上长时间运行。
3
理想很丰满,现实很骨感:降噪的五大难题
尽管需求明确,但工程实现中面临诸多棘手痛点:
稳态噪声与非稳态噪声的博弈:
传统谱减法、Wiener滤波对空调、风扇等稳态噪声效果尚可,但面对键盘声、敲门声、餐具碰撞等非稳态噪声时,往往束手无策。这类噪声时域特征明显,频谱变化快,传统统计模型难以跟踪。
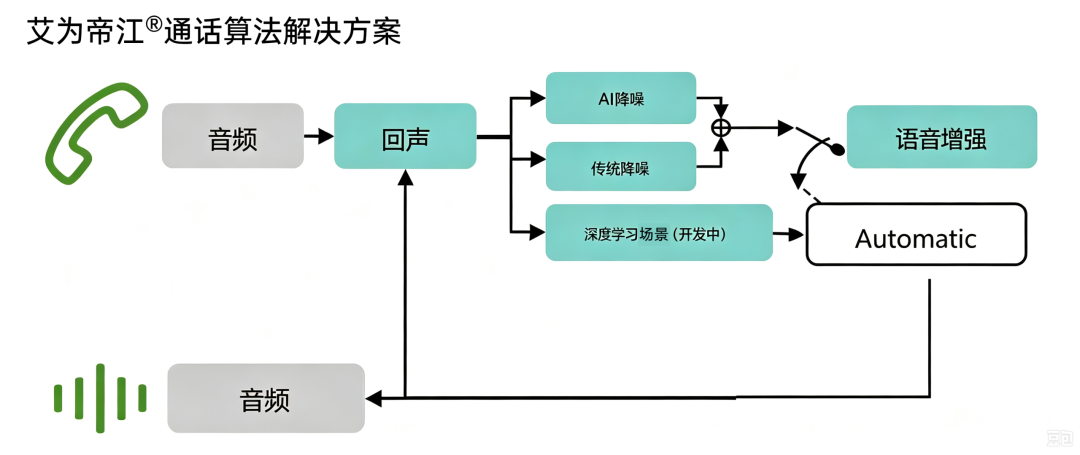
图6 艾为通话场景降噪解决方案
风噪处理的难题:
风吹麦克风产生的低频能量极高,且与语音频带严重重叠。传统算法容易将风噪误判为语音,或过度抑制导致语音严重失真。户外场景下,风噪直接决定了通话体验的底线。风噪并非声波,而是湍流对麦克风振膜的随机压力扰动,其频谱能量集中在低频(<1kHz),且与语音基频高度重叠。前馈麦克风的振膜直接承受风压,产生严重的低频饱和;即使加防风海绵,物理衰减也有限。
算法层面,风噪检测通常依赖零交叉率(ZCR)和低频能量占比的联合判决,但高风速下(>5m/s),风噪功率超过语音10dB以上,传统的VAD+增益控制策略失效,需要基于多麦克风相位差或骨传导辅助的可靠语音检测。
在这一领域,艾为已经做出了有竞争力的方案。以艾为帝江®的AI降风噪算法为例,AI降风噪方案整体主观得分提升约33%;不同风速场景下优势稳定:4m/s 场景提升约 27%,5-7m/s 户外场景提升约 35%,13m/s 强风极端场景提升约 43%。客观测试参考P.835标准,SIG指标在快走、慢跑、摩托车等场景下均有明显提升。
降噪与语音损伤的矛盾:
降噪的本质是“减法”——从带噪信号中减去估计的噪声。减得不够,噪声残留明显;减得过多,语音细节被连带切除,产生“音乐噪声”(musical noise)或频谱空洞。如何在两者之间取得平衡,是算法调优的核心难点。
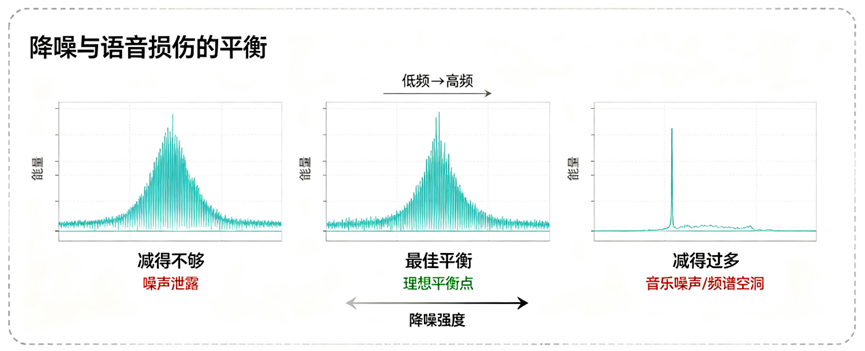
图7 降噪与语音损伤的平衡
多场景切换的适配困境:
用户从安静的办公室走到嘈杂的街道,再进入高速行驶的汽车,声学环境瞬息万变。固定参数的降噪方案无法适应这种动态变化,而自适应算法又面临收敛速度和稳定性之间的权衡。
硬件算力的天花板:
高端DSP可以运行复杂的深度学习模型,但中低端芯片和TWS耳机的算力极其有限。如何在算力约束下实现接近高端设备的降噪效果,是量产落地的关键瓶颈。
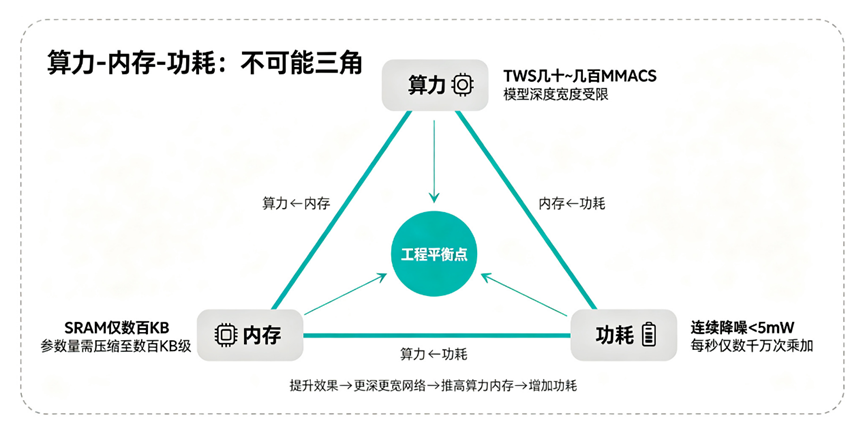
图8 算力-内存-功耗:不可能三角
4
破局之路:从“单兵作战”到“协同进化”
面对上述痛点,音频降噪技术正在经历从"单兵作战"到"协同进化"的范式转变:
传统算法与深度学习的融合:
纯深度学习模型(如RNNoise、DeepFilterNet)在非稳态噪声抑制上表现优异,但算力消耗较大。工程实践中,常采用"传统+AI"的混合架构:传统算法快速收敛处理稳态噪声,深度学习模型负责非稳态噪声和瞬态噪声的精细化抑制,两者互补,兼顾效果与效率。
这种融合架构已经在量产方案中得到验证。艾为自研艾为帝江®在通话场景的降噪解决方案正是这一思路的典型代表——依托9年以上的算法自主研发积淀和累计超过20亿台设备的装机验证,将传统信号处理的快速收敛与AI模型的精细化抑制深度结合,在穿戴设备的有限算力下实现了出色的降噪效果。
多麦克风阵列与波束成形:
单麦克风降噪只能利用频域信息,而双麦或多麦阵列可以引入空间维度。通过波束成形(Beamforming)技术,将拾音波束指向目标说话人方向,同时抑制其他方向的噪声。这在车载、会议宝、智能音箱等场景中已成为标配。
在穿戴设备上,需采用INT8量化(权值和激活值)、结构化剪枝(移除不重要的通道)、以及知识蒸馏(大模型指导小模型)。此外,利用麦克风阵列的空域信息,可将单通道降噪与波束成形(MVDR/GSC)级联:波束成形提供6-12dB的指向性增益,降低后续单通道算法的难度,允许使用更轻量的网络。艾为帝江®方案支持2-8路多麦克风阵列,通过波束成形实现个人音区拾音,配合8字形、超指向等多种波束形态,有效抑制带外干扰信号,在翻译、通话等场景中大幅提升目标语音的信噪比。
多传感器融合与场景感知:
高端方案引入骨传导麦克风或加速度计作为语音活动的可靠参考——骨导信号对空气传播噪声免疫,仅拾取颅骨振动传递的语音。通过骨导与气导的互相关分析,可构建高置信度的VAD,指导降噪增益的施加时机。
在翻译等对拾音距离有特殊要求的场景,多气麦加VPU(语音拾取单元)的联合远近场拾音方案已经落地,通过DM-BF双差分麦阵列区分远近场音源,配合近场/远场抑制算法,实现独立音区拾音。
同时,基于轻量级CNN的场景分类器(安静/街道/车载/大风)实时切换降噪策略:大风场景启用风噪专用滤波器,车载场景加强低频抑制,实现真正的自适应。
5
结语
音频降噪技术的终极目标,不是让环境变得寂静无声,而是在嘈杂中守护那一份清晰的沟通。从谱减法到深度学习,从单麦到阵列,从固定参数到自适应智能,技术的每一次进化,都在缩小理想体验与现实环境之间的距离。
未来2-3年的上行音频算法将持续向AI化、多模态、全场景方向演进:2026年将落地通用AI降噪、特定场景AI降噪(室内/室外/办公室/地铁站)、指向波束(超指向、8字、心形、近远场波束)、声源定位、AI回声消除、音频变焦、语音唤醒(VAD+KWS)等;2027年将进一步推进多模态噪声抑制(按键、挥手)、声纹识别(声纹活动检测+声纹降噪)、大模型ASR第三方接入等创新应用。通过轻量级的场景分类网络,实时判断当前处于“安静室内”、“街道”、“车载”还是“大风环境”,自动切换对应的降噪策略和参数配置,实现真正的全场景自适应。
同时,艾为在硬件层面的全链路布局——从音频PA(1W~300W功率驱动)、Codec/ADC/DAC(高信噪比>112dB、高采样率低延时<100uS)、音频总线(100Mbps车载Soundwire)、ADSP/NPU为算法落地提供了从芯片到算法的完整系统级解决方案。